Wie Unternehmen verhindern, dass ihnen ihre Datenlandschaft erneut entgleitet.
Wer um die Jahrtausendwende Verantwortung für IT trug, kennt das Muster: Ein Fachbereich brauchte eine Lösung, die zentrale IT hatte andere Prioritäten oder zu lange Vorlaufzeiten. Also entstanden Access-Datenbanken, Excel-Lösungen und Makros. Das war oft sinnvoll. Ein konkretes Problem wurde pragmatisch und schnell gelöst.
Schwierig wurde es später: Aus Hilfslösungen wurden geschäftskritische Anwendungen. Daten wurden aus zentralen Systemen importiert, angereichert und weitergegeben. Wer die Lösung ursprünglich gebaut hatte, war längst weg, Dokumentation lückenhaft, Ownership unklar. Abschalten konnte man die Anwendung trotzdem nicht mehr.
Mit KI erleben wir heute eine ähnliche Dynamik – nur erheblich schneller.
Heute braucht es dafür kaum noch technische Fähigkeiten
Mitarbeitende können innerhalb weniger Minuten Dokumente in einen KI-Dienst laden, Meetings transkribieren lassen, Browser-Erweiterungen installieren, SaaS-Dienste verbinden oder eine KI-Funktion nutzen, die der bestehende Softwareanbieter gerade neu aktiviert hat. Jeder einzelne Schritt kann fachlich sinnvoll sein.
Die entscheidende Frage lautet trotzdem: Weiss das Unternehmen noch, was dabei mit seinen Daten geschieht?
Microsoft verwendet dafür inzwischen den Begriff Shadow AI: KI-Dienste, die ausserhalb der etablierten Governance von IT und Security genutzt werden. Als Risiken nennt Microsoft unter anderem Datenabfluss und regulatorische Verstösse (Microsoft). Das Problem beschränkt sich aber nicht nur auf nicht freigegebene Chatbots. KI kommt zunehmend über bereits vorhandene Anwendungen ins Unternehmen. Die Applikation bleibt dieselbe, der Datenfluss dahinter möglicherweise nicht.
«Welche Systeme haben wir?» ist inzwischen die einfachere Frage
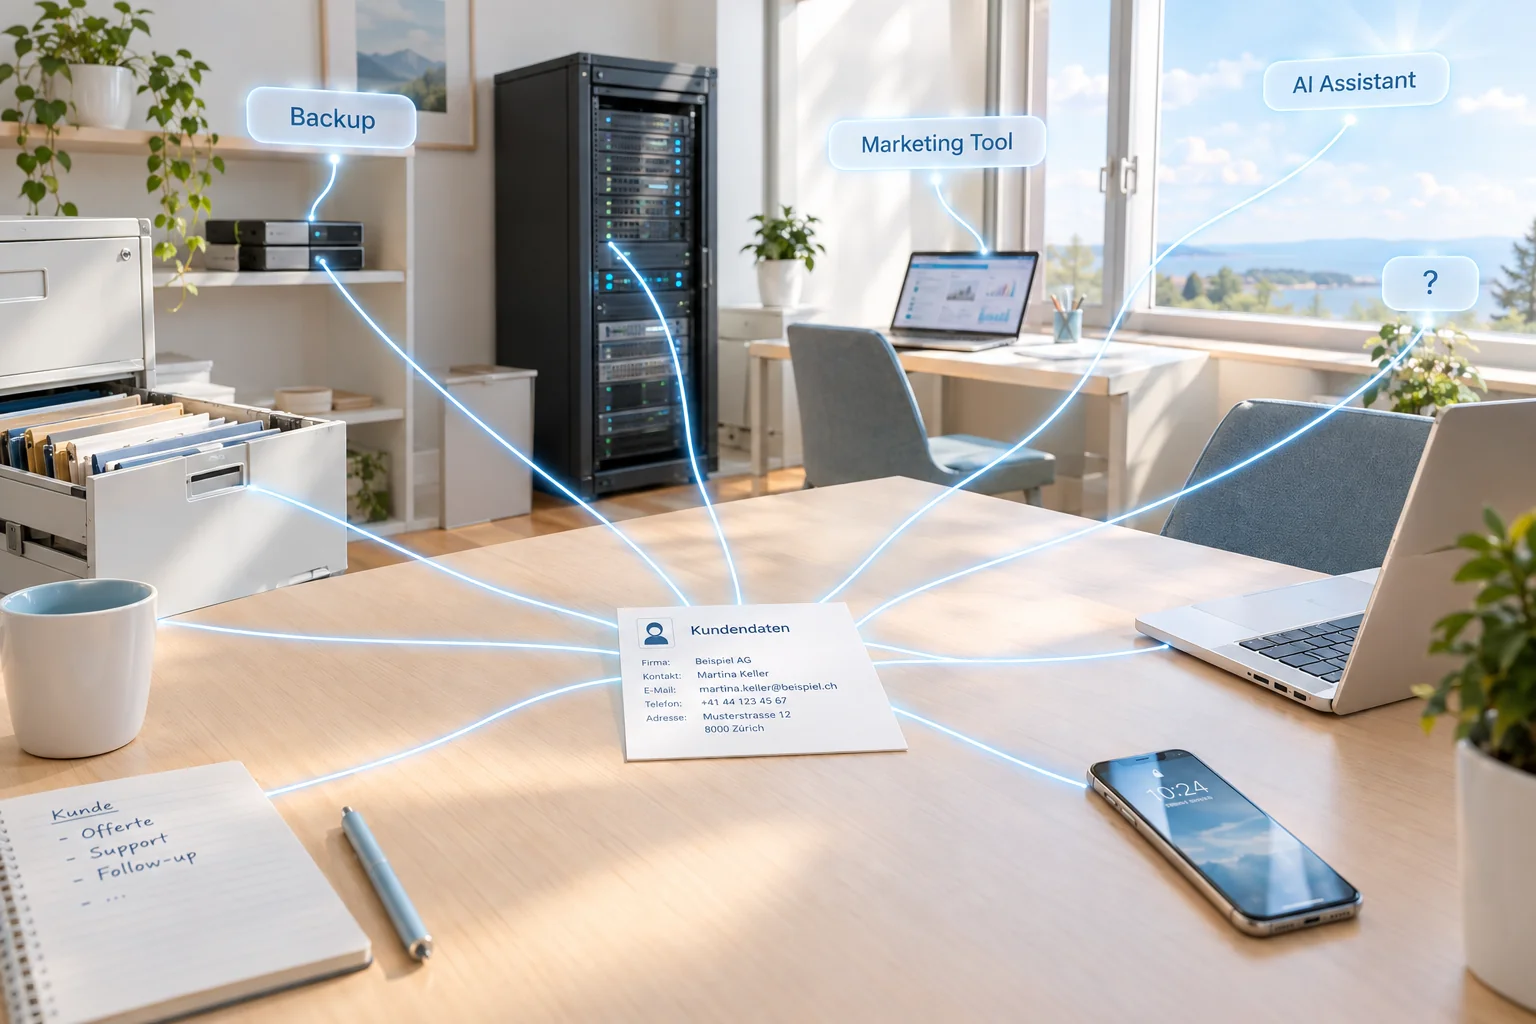
In Projekten im öffentlichen und regulierten Umfeld begegnet uns immer wieder dieselbe Differenz. Die Frage «Welche Systeme setzen wir ein?» lässt sich meist gut beantworten. Bei «Welche Systeme, Schnittstellen, Anbieter und Unterauftragnehmer verarbeiten diese Daten tatsächlich?» wird es erheblich anspruchsvoller. Beispiel: ein CRM verarbeitet Kundendaten. Soweit bekannt. Aber:
- Welche Schnittstellen lesen sie?
- Welche SaaS-Dienste greifen darauf zu?
- Welche Hersteller verwenden Unterauftragnehmer?
- Wo werden Daten verarbeitet?
- Welche KI-Funktionen wurden inzwischen ergänzt?
- Wer überprüft, ob die vor zwei Jahren dokumentierte Verarbeitungskette noch stimmt?
Das ist kein neues KI-Problem. KI beschleunigt ein bestehendes Governance-Problem.
Governance beginnt mit Ownership
Beim Begriff AI Governance entsteht schnell das Bild neuer Frameworks, Policies und Steering Committees. Das kann notwendig sein. Es ist aber nicht der Ausgangspunkt. NIST empfiehlt für generative KI ausdrücklich, bestehende Governance- und Risikomechanismen weiterzuverwenden und für die Besonderheiten von GenAI anzupassen. Dazu gehören auch Risiken entlang der Kette von Drittanbietern (NIST). Die erste Frage lautet deshalb nicht: «Haben wir ein AI-Governance-Framework?» Sondern: «Wer entscheidet?»
- Der Fachbereich beurteilt den fachlichen Nutzen.
- IT prüft Integration und Betrieb.
- Security beurteilt Sicherheitsrisiken.
- Legal prüft Verträge.
- Datenschutz beurteilt die Datenbearbeitung.
Alle haben ihren Teil erledigt. Aber wer sagt am Ende Ja oder Nein? Und wer bleibt dafür verantwortlich, dass die Entscheidung im Betrieb auch ein Jahr später noch stimmt? Das ist der Unterschied zwischen Beteiligung und Ownership.
Die Verantwortung endet nicht beim Cloud-Anbieter
Wer Personendaten an einen Cloud-, SaaS- oder IT-Dienstleister überträgt, gibt damit seine Verantwortung nicht ab. Der EDÖB hält ausdrücklich fest, dass der Verantwortliche auch bei Auftragsbearbeitung für den Datenschutz verantwortlich bleibt und seinen Dienstleister entsprechend auswählen, instruieren und gegebenenfalls überwachen muss (EDÖB). Auch KI ist datenschutzrechtlich keine Sonderwelt. Das Schweizer Datenschutzgesetz gilt technologie-neutral auch für KI-gestützte Datenbearbeitung (EDÖB).
Die GL muss nicht jeden Subprozessor jedes SaaS-Dienstes kennen. Sie muss wissen, wer ihn kennt und wer dafür verantwortlich ist, dass diese Information aktuell bleibt.
Das wird spätestens dann relevant, wenn jemand fragt: «Wo landen diese Daten eigentlich?» Denn ein Vertrag mit Anbieter A bedeutet nicht automatisch, dass ausschliesslich Anbieter A beteiligt ist. Cloud-Infrastruktur, Support, Analysekomponenten oder weitere technische Leistungen können durch andere Unternehmen erbracht werden. Wenn Personendaten ins Ausland gelangen, muss bekannt sein, wo Daten bearbeitet werden beziehungsweise welche Auftrags- und Unterauftragsbearbeiter beteiligt sind. Je nach Empfängerland können zusätzliche Garantien erforderlich sein (EDÖB).
Die praktische Frage lautet deshalb: Könnten Sie für drei zufällig ausgewählte Systeme heute die Verarbeitungskette zeigen? Nicht «irgendwo müsste das dokumentiert sein». Sondern tatsächlich zeigen.
Beispiel: Der Kunde will seine Daten gelöscht haben
Freitag, 09:12 Uhr. Ein Kunde schreibt nicht einfach: «Bitte nehmen Sie mich aus Ihrem Newsletter.» Er verlangt Auskunft über die zu seiner Person gespeicherten Daten und deren Löschung, soweit keine Grundlage für die weitere Speicherung besteht.
Im CRM ist der Kunde schnell gefunden. Im ERP ebenfalls. Dann wird es interessanter.
- Im Ticketsystem liegen Supportfälle.
- Im Fileshare Projektunterlagen.
- E-Mails befinden sich in mehreren Postfächern.
- Marketing hat Kontaktdaten an einen externen Dienst übermittelt.
- Vor zwei Jahren wurde ein Export für eine Analyse erstellt.
- Im Data Warehouse liegt eine historische Kopie.
- Ein SaaS-Dienst verwendet weitere Unterauftragnehmer.
- Ein KI-Assistent wurde zeitweise mit Supportinformationen getestet.
Und irgendwann fragt jemand: «Was ist eigentlich mit unseren Backups?»
Am Freitag fragt der Datenschutzverantwortliche bei IT nach. Am Montag fragt IT die Fachbereiche. Am Dienstag wird der Marketingdienstleister kontaktiert. Am Donnerstag taucht eine Fachapplikation auf, die in der ursprünglichen Liste nicht vorkam. Eine Woche später stellt sich heraus, dass einer der Anbieter weitere Dienstleister verwendet. Spätestens jetzt lautet die Frage: «Sind wir sicher, dass wir alle relevanten Datensätze gefunden haben?»
Das Problem ist nicht der Wille zur Löschung. Das Problem ist, dass viele Unternehmen nicht mehr zuverlässig sagen können, wo die Daten überall liegen – und damit auch nicht, ob sie tatsächlich vollständig gelöscht wurden.
- In einer beherrschten Datenlandschaft ist eine solche Anfrage ein definierter Prozess: Identify. Decide. Delete. Document. Get coffee.
- In einer gewachsenen Schattenlandschaft wird daraus: Search. Escalate. Audit. Search again.
Corporate und KMU: dasselbe Problem, andere Voraussetzungen
Grossunternehmen verfügen typischerweise über spezialisierte Funktionen für Architektur, Security, Datenschutz, Risk, Legal, Procurement oder Data Governance. Dort besteht die Herausforderung häufig darin, dass die Technologie schneller wächst als die bestehenden Freigabe- und Kontrollprozesse. Im KMU fehlen viele dieser Funktionen als eigene Organisationseinheiten. Dafür sind Entscheidungswege kürzer und Systemlandschaften meist überschaubarer. Ein KMU braucht deshalb nicht die Governance eines internationalen Konzerns. Aber es braucht Antworten auf dieselben grundlegenden Fragen:
- Welche Daten haben wir?
- Wo liegen sie?
- Welche Systeme verarbeiten sie?
- Welche externen Unternehmen erhalten sie?
- Wer entscheidet darüber?
- Wer ist verantwortlich, wenn sich etwas ändert?
Dafür braucht es möglicherweise kein 80-seitiges Regelwerk. Eine vollständige Applikationsübersicht, definierte Owner, eine einfache Datenklassifikation und einige Regeln, die tatsächlich verstanden und angewendet werden, können erheblich wertvoller sein.
KI erzeugt diese Lücken nicht. Sie macht sie sichtbar.
Wenn ein Unternehmen heute nicht weiss, welche KI-Dienste Unternehmensinformationen erhalten, hatte es möglicherweise schon vorher Schwierigkeiten mit seiner SaaS-Landschaft. Wenn niemand Data Owner für einen KI-Anwendungsfall sein möchte, war Data Ownership vielleicht schon vorher nicht sauber geregelt. Wenn eine Löschanfrage zur Expedition durch die IT-Landschaft wird, ist das ebenfalls kein neues KI-Problem.
Mit Access entstand Wildwuchs über Jahre. Mit SaaS, APIs und KI kann er innerhalb von Monaten entstehen – und das wird nur schneller, nicht langsamer.
Selbst-Check: Wie gut kennen Sie Ihre Datenlandschaft?
Sie müssen nicht jede Antwort persönlich kennen. Aber Ihre Organisation sollte wissen, wer sie kennt.
- 1. Datenschutz: Weiss die GL, wofür das Unternehmen verantwortlich bleibt – auch bei Cloud-, SaaS- und KI-Anbietern?
- 2. Mitarbeitende: Wissen sie, was Personendaten sind und welche Informationen sie in externe Dienste eingeben dürfen?
- 3. Regulator: Können Sie für drei beliebige Systeme Datenflüsse, Schnittstellen, Anbieter, Unterauftragnehmer und Bearbeitungsorte zeigen?
- 4. Löschung: Ist eine Löschanfrage ein definierter Prozess – oder der Beginn eines Discovery-Projekts?
- 5. Shadow AI: Wissen Sie, welche KI tatsächlich genutzt wird – nicht nur welche offiziell beschafft wurde?
- 6. Neue Features: Wer merkt, wenn ein SaaS-Anbieter eine neue KI-Funktion aktiviert, und wer beurteilt sie?
- 7. Ownership: Wer entscheidet letztlich – und wer bleibt danach verantwortlich?
Problematisch wird es erst, wenn niemand weiss, wer die Antwort wissen müsste. Dort beginnt Governance.
Webinar: KI aus technischer und Managementperspektive
Wie viel Governance braucht ein Unternehmen tatsächlich? Wann wird sinnvolle Eigeninitiative zu Shadow AI? Wie lassen sich Geschwindigkeit und Kontrolle miteinander verbinden?
Diese und weitere Fragen behandeln wir in unserem kommenden Webinar aus technischer und unternehmerischer Perspektive.
Das Webinar ist in Vorbereitung. Wenn Sie eine persönliche Einladung erhalten möchten, melden Sie sich über unser Kontaktformular mit dem Stichwort «KI-Webinar».
Praxis-Workshop KI – Q4 2026
Keine Hochglanz-Präsentationen. Keine konstruierten Case Studies. Keine Verkaufsveranstaltung.
Wir arbeiten an realen Situationen aus Unternehmen: konkreten Prozessen, Use Cases sowie Daten-, Technologie- und Governance-Fragen – aus fachlicher und technischer Perspektive.
Sie bringen Ihre Fragestellung und Ihre Zeit mit. Wir bringen Erfahrung, kritische Fragen und zwei unterschiedliche Blickwinkel mit.
Die Teilnahme ist kostenlos und unverbindlich. Details und Termine folgen.
Quellen
- Microsoft, «Introducing spreadsheet controls in the new Office», September 2012.
- Microsoft Learn, «Prevent data leak to shadow AI».
- NIST, «Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile», NIST AI 600-1, Juli 2024.
- EDÖB, «Outsourcing (Auftragsdatenbearbeitung)».
- EDÖB, «KI und Datenschutz», September 2025.
- EDÖB, «Bekanntgabe von Personendaten ins Ausland».
- EDÖB, «Auskunftsrecht».